ARTÍCULO DE INVESTIGACIÓN
Modelo de gestión de inventario y abastecimiento basado en redes neuronales
Inventory and supply management model based on neural networks
DOI: https://doi.org/10.61154/metanoia.v12i1.4079
Dennysse Marisol Castillo Martinez 1
Daniel Beltrán del Hierro 2
1 E- mail: denysse.castillo@upec.edu.ec Afiliación: Universidad Politécnica Estatal del Carchi, Tulcán, Ecuador. ORCID: https://orcid.org/0009-0008-7784-3475
2 E- mail: daniel.beltran@upec.edu.ec Afiliación: Universidad Politécnica Estatal del Carchi, Tulcán, Ecuador. ORCID: https://orcid.org/0000-0003-2888-4007
Recibido: 03/06/2025 Revisado: 13/06/2025
Aprobado: 03/07/2025 Publicado: 01/01/2026
RESUMEN
El modelado de inventarios permite entender el comportamiento de los sistemas de abastecimiento y demanda en una empresa mediante la construcción, solución y análisis de representaciones del mundo real, facilitando la gestión operativa. Este estudio combina la inteligencia artificial con la teoría matemática de los inventarios para mejorar el control de las existencias. Tras evaluar la situación actual de la empresa, se determinó que el modelo de Cantidad Económica de Pedido (EOQ) probabilístico era el más adecuado para optimizar los costos en un entorno de demanda variable, abordando problemas como la ruptura del inventario o exceso del mismo, mediante el punto de pedido y el stock de seguridad. Se entrenaron cinco redes neuronales con el objetivo de combinar su capacidad predictiva con el modelo EOQ. Entre ellas, destacó la arquitectura 3-6-1 con el optimizador ADAM, la cual alcanzó una precisión del 98%. Su implementación permitió una reducción del 27 % en los costos operativos.
Descriptores: Inventario; gestión industrial; oferta y demanda; inteligencia artificial; redes neuronales.
ABSTRACT
Inventory modeling provides insights into the dynamics of a company's supply and demand systems by constructing, solving, and analyzing realistic representations, thereby enhancing operational management. This research integrates artificial intelligence with mathematical inventory theory to refine inventory control practices. Following an assessment of the company's current circumstances, it was concluded that the probabilistic Economic Order Quantity (EOQ) model was best suited for optimizing costs in a variable demand environment. This model effectively addresses challenges such as inventory shortages and excess stock through the implementation of reorder points and safety stock levels. Five neural networks were trained to leverage their predictive capabilities in conjunction with the EOQ model. Notably, the 3-6-1 architecture utilizing the ADAM optimizer achieved an impressive 98% accuracy. The application of this model resulted in a 27% reduction in operating costs.
Descriptors: Inventory; Industrial management; supply and demand; artificial intelligence; neural networks.
INTRODUCCIÓN
El control de inventarios es una pieza clave para asegurar el éxito de las empresas, especialmente en entornos de mercado caracterizados por la incertidumbre y la demanda fluctuante. Las empresas deben equilibrar la oferta y demanda, reducir costos y mejorar el desempeño logístico, lo que implica tener los productos adecuados en el momento y lugar correctos (Cristopher, 2011). Sin embargo, la volatilidad en la demanda puede provocar faltantes que afectan las ventas y la satisfacción del cliente, mientras que el exceso de stock genera costos adicionales y riesgo de obsolescencia. Este estudio se enfoca en una empresa textil que carece de un modelo de gestión de inventario adecuado, generando desequilibrios al no poder determinar con precisión la cantidad exacta de productos a mantener en stock, ni el momento oportuno para realizar nuevos pedidos.
Investigaciones previas como la de Chachalo & Valencia (2025); Kotecha & Rio (2024) destacan que la implementación de redes neuronales en modelos de inventario puede reducir los costos y tiempos de respuesta en la cadena de suministro. Las redes neuronales pueden mejorar la precisión en el cálculo del tamaño de pedido, lo que refleja el potencial de la inteligencia artificial para transformar la logística empresarial. Estos avances sugieren que la integración de redes neuronales en la gestión de inventarios puede ofrecer soluciones innovadoras a problemas tradicionales, especialmente en empresas que enfrentan incertidumbre en la demanda.
Este estudio tiene como finalidad integrar la base matemática de los inventarios con algoritmos de aprendizaje automático para mejorar el aprovisionamiento de la empresa textil en cuestión. Para ello, se llevará a cabo un diagnóstico del modelo actual y, a partir de los hallazgos, se diseñará un nuevo modelo adaptado a las condiciones específicas de la empresa. Este modelo también se podrá replicar en otras organizaciones del sector textil, proporcionando bases teóricas y operativas que ayude a las empresas a adaptarse a un entorno de mercado dinámico, contribuyendo al desarrollo de metodologías innovadoras en la gestión logística.
METODOLOGÍA
Este estudio tuvo un enfoque cuantitativo, se analizó desde una perspectiva matemática el rendimiento y funcionalidad del modelo de gestión de inventario actual de la empresa, así como el efecto causado en el abastecimiento. Dado que las variables estudiadas son de naturaleza numérica fue posible calcular, evaluar y relacionar matemáticamente los resultados.
Para la recolección de información, se usó como instrumento principal una ficha de observación, conformada por indicadores clave de desempeño, permitiendo monitorear, evaluar y analizar de manera sistemática información relevante sobre los 354 tipos de tela que comercializa la empresa.
Se recopiló 81,260 datos durante un periodo de un año. Estos datos fueron extraídos de los registros históricos de la empresa, Incluyendo la demanda mensual de cada tipo de tela, las diferencias entre el inventario en sistema y el inventario físico, las ventas mensuales, la cantidad de metros por rollo y la cantidad actual de rollos disponibles, proporcionando una muestra suficiente y representativa para el análisis.
Este conjunto de datos permitió capturar variaciones en el inventario y el abastecimiento, asegurando que se reflejen tendencias y patrones relevantes. La duración del periodo de estudio es adecuada para evaluar la efectividad del modelo para el control de inventario en condiciones dinámicas, considerando el factor de la demanda aleatoria.
El análisis de datos se realizó utilizando métodos estadísticos descriptivos e inferenciales empleando herramientas como Python y Excel para procesar y visualizar los resultados. Primero se organizó una base de datos no estructurada en Excel con información sobre los tipos de tela, costos, precios de venta, ventas y la capacidad de adquisición de la empresa. Luego los datos fueron depurados y categorizados. Posteriormente, se utilizó Python para calcular el punto de pedido, y el tamaño de lote ideal, lo que permitió analizar las variables y su relación, facilitando la toma de decisiones en la gestión de inventarios.
Finalmente, para el análisis estadístico se ejecutó la prueba no paramétrica de Wilcoxon para comparar la cantidad inicial de pedido con la cantidad óptima, lo que permitió rechazar la hipótesis nula y confirmar una diferencia significativa entre ambos grupos.
RESULTADOS Y DISCUSIÓN
Análisis ABC
Se realizó un análisis ABC (Tabla 1) para clasificar los 354 tipos de tela según su impacto en el inventario de la empresa, con el objetivo de optimizar el control de inventarios y enfocar recursos en los productos más críticos. Este análisis permitió identificar los productos más relevantes para la empresa, facilitando la toma de decisiones sobre reposiciones, disminución de costos y mejor servicio al cliente. Dando como resultado que 187 tipos de tela se encuentran en la categoría A (artículos más valiosos) representando al 53 % del total del inventario y generando el 80 % del costo total del mismo.
Tabla 1.
Análisis ABC
|
Costo Total $ |
% |
Cantidad (metros) |
Categoría |
Cantidad categoría |
|
|
191,811.66 |
80 |
19,644 |
A |
187 |
|
|
35,925.28 |
15 |
8,841 |
B |
91 |
|
|
12,142.91 |
5 |
6,414 |
C |
76 |
|
|
Total |
239,879.85 |
100 |
34,899 |
|
354 |
Fuente: Los autores. Situación actual del modelo de gestión de inventario y abastecimiento
Se evaluó el modelo actual de gestión de inventario y abastecimiento mediante indicadores clave de rendimiento (KPI) (Mora, 2012), los cuales reflejan tanto el estado del sistema como la capacidad operativa para cubrir la demanda. Algunos KPI se presentan con doble resultado (inventario físico y en sistema) esta comparación facilita la detección de ineficiencias y áreas de mejora, permitiendo ajustar los procesos para un manejo de inventario más preciso y confiable.
Los resultados (Tabla 2) muestran una exactitud del inventario del 92.96%, con discrepancias moderadas. La rotación fue baja (0.32 físico, 0.30 sistema) y la duración del inventario excesiva (más de 2200 días), lo que indica lentitud en el movimiento de productos. El nivel de servicio, de apenas 36.15 %, refleja dificultades para cumplir pedidos. Aunque el valor del inventario es de $239,879.85, no representa un problema directo, pero podría optimizarse. Finalmente, la eficiencia del abastecimiento fue baja (34.98 % físico, 32.42 % sistema), señalando fallas en el proceso de reposición.
Tabla 2.
Resumen indicadores KPI
|
Indicador KPI |
Resultado |
Requiere mejora |
|
Exactitud del inventario |
92.96 % |
Moderada |
|
Rotación de mercancía |
Registro Físico: 0.32 Registro en sistema: 0.30 |
Alta |
|
Duración del inventario |
Registro Físico: 2229 días Registro en Sistema: 2539 días |
Alta |
|
Nivel de servicio |
36.15 % (general) 74.32 % (máxima) 63.85 % (mensual) |
Alta |
|
Valor económico del inventario |
$239,879.85 |
No aplica |
|
Eficiencia del abastecimiento |
Inventario Físico: 34.98 % Inventario en Sistema: 32.42 % |
Alta |
Fuente: Los autores
Análisis de la demanda
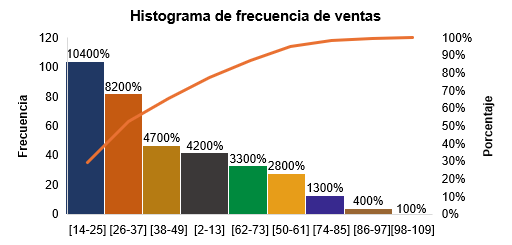
Se realizó mediante un enfoque estadístico que permitió entender el comportamiento de las ventas. A través de una distribución basada en observaciones, se refleja el número de metros vendidos por jornada de cada tipo tela, lo que permite identificar patrones en el comportamiento de la demanda. Los resultados indicaron que la demanda es de tipo estocástico, caracterizada por su aleatoriedad y variabilidad. Un hallazgo importante fue que el 65.82 % de las ventas se concentra en productos que varían entre 14 y 49 metros (Figura 1), mientras que el 5.08 % de las ventas corresponde a productos con una mayor demanda, en el rango de 74 a 109 metros. Esta distribución sugiere que la mayoría de los productos más vendidos son aquellos con un menor inventario disponible, lo que podría llevar a desabastecimientos si no se gestionan adecuadamente. Este análisis permitió optimizar el reabastecimiento y ajustar el inventario según la demanda real.
Figura 1.
Histograma de frecuencia de
ventas
Existe una gran variedad de modelos de gestión de inventario, pero no todos son capaces de capturar patrones no lineales en los datos. En su mayoría estos modelos están diseñados para situaciones donde la demanda es predecible y el suministro es constante, lo que limita su efectividad en entornos cambiantes. La demanda puede fluctuar drásticamente y los tiempos de entrega son inciertos (Taha, 2024), es importante contar con modelos que no solo se ajusten a condiciones estándar, sino que también puedan adaptarse a la variabilidad del mercado. Esto subraya la necesidad de enfoques más sofisticados que integren algoritmos inteligentes de análisis de datos para optimizar la gestión de inventarios.
Con base en el comportamiento incierto de la demanda identificada en la empresa estudiada, se realizó una revisión documental de modelos de inventario tipo probabilísticos (Tabla 3). Esta revisión se centró en métodos que permiten calcular la cantidad óptima de pedido, inventario de seguridad y el punto de pedido, elementos clave para mejorar la gestión en condiciones de incertidumbre (Render & Heizer, 2014).
Mediante esta revisión bibliográfica, se establecerán las bases teóricas que respaldarán la implementación del modelo propuesto, garantizando que la empresa optimice su abastecimiento y reduzca costos operativos, al tiempo que se prepara para adaptarse a las variaciones en la demanda del mercado (Bowersox et al., 2024).
Tabla 3.
Comparación de modelos
probabilísticos
|
Aspecto |
EOQ probabilístico |
Revisión Periódica |
|
Frecuencia de pedido |
Continua, adapta da a la demanda |
Periódica, en intervalos definidos |
|
Cantidad de pedido |
Variable, optimizada para minimizar costos. |
Variable, depende del nivel de inventario al momento de revisión. |
|
Demanda |
Aleatoria, no asume una distribución específica. |
Aleatoria, se estima para cada periodo. |
|
Complejidad |
Requiere análisis estadístico |
Menos análisis necesario |
|
Nivel de servicio |
Controlada mediante la cantidad óptima de pedido |
Controlado mediante revisiones frecuentes |
|
Flexibilidad |
Se adapta a cambios en la demanda y costos |
Permite ajustes en cada revisión. |
Fuente: Los autores
La elección del EOQ probabilístico se fundamenta en su capacidad para manejar la incertidumbre en la demanda. A diferencia de la revisión periódica, se basa en intervalos fijos. Esto no solo optimiza la cantidad de pedido, sino que también mejora el nivel de servicio y la flexibilidad.
Diseño de la Red Neuronal
Esta investigación combinó automatización inteligentes, explorando elementos informáticos y el uso de algoritmos para optimizar procesos con la teoría matemática de los inventarios (Walczak, 2019). A través de la revisión bibliográfica, se determinó que el modelo EOQ con demanda probabilística, integrado con una red neuronal artificial, se ajustaría de manera efectiva a las operaciones de la empresa textil.
Se diseñaron cinco redes neuronales con el objetivo de predecir la cantidad óptima de pedido. Para todas las redes, se utilizaron como datos de entrada las variables de demanda que permite a la red neuronal predecir las necesidades futuras de productos ajustando el nivel de inventario para evitar desabastecimientos o excesos. El costo de almacenamiento porque ayuda a optimizar el nivel de inventario, considerando los gastos asociados al mantenimiento del stock. Por último, el punto de reorden que define el momento adecuado para realizar nuevos pedidos, asegurando que el inventario se conserve en los niveles requeridos y se eviten interrupciones en las operaciones. Estas variables permiten que las redes neuronales generen predicciones más precisas y gestionen de manera eficiente los inventarios.
En la Tabla 4 se presenta las características de los modelos no seleccionados. Estos modelos fueron evaluados en función de diversos parámetros, pero no cumplieron con los requisitos necesarios para obtener los mejores resultados.
Tabla 4.
Características de los modelos
no seleccionados
|
Red Neuronal |
Tipo de capa |
Inicializador |
Tasa de aprendizaje |
Optimizador |
RMSE |
|
RN 1 |
Dense |
Glorot |
0.001 |
ADAM |
21.12 |
|
RN 2 |
Dense |
Glorot |
0.01 |
ADAM |
8.868 |
|
RN 3 |
Dense |
Normal |
0.01 |
SGD |
51.88 |
|
RN 4 |
Dense |
Normal |
0.001 |
ADAM |
7.495 |
Fuente: Los autores
A continuación, en la Tabla 5, se muestran algunos de los resultados de los modelos no seleccionados con el fin de proporcionar una visión sobre algunas de las predicciones generadas y las limitaciones observadas durante la evaluación. Para cada red, se realizaron 250 pronósticos con el objetivo de evaluar su capacidad de predicción y determinar su efectividad. Estos resultados permiten comprender los aspectos que llevaron a tomar la decisión de no optar por estos modelos.
Tabla 5.
Resumen de resultados de
predicción por Red Neuronal
|
Red Neuronal |
Valor Actual (EOQ) |
Predicción (EOQ) |
Diferencia |
Predicciones exactas o cercanas |
|
RN 1 |
81.25 |
125.12 |
-43.87 |
Ninguna exacta, grandes diferencias |
|
47.50 |
85.71 |
-38.21 |
||
|
60.75 |
102.32 |
-41.57 |
||
|
10.00 |
72.65 |
-62.65 |
||
|
33.50 |
19.42 |
14.07 |
||
|
RN 2 |
81.25 |
95.80 |
-14.55 |
Predicciones razonables cercanas |
|
47.50 |
50.89 |
-3.39 |
||
|
60.75 |
77.84 |
-17.09 |
||
|
10.00 |
7.50 |
2.49 |
||
|
33.50 |
25.72 |
7.77 |
||
|
RN 3 |
81.25 |
88.42 |
-7.17 |
Ninguna cercana, valores constantes |
|
47.50 |
88.42 |
-40.92 |
||
|
60.75 |
88.42 |
-27.67 |
||
|
10.00 |
88.42 |
-78.42 |
||
|
33.50 |
88.42 |
-54.92 |
||
|
RN 4 |
81.25 |
72.76 |
8.48 |
|
|
47.50 |
54.42 |
-6.92 |
1 predicción muy cercana (0.96) |
|
|
60.75 |
70.19 |
-9.44 |
||
|
10.00 |
18.40 |
-8.40 |
||
|
33.50 |
34.46 |
0.96 |
Fuente: Los autores
El desempeño de los modelos se evaluó principalmente mediante el RMSE, un indicador que refleja la precisión de las predicciones frente a los valores reales, donde valores más bajos indican mayor exactitud. El modelo RN 1 presentó el RMSE más alto, lo que evidenció una pobre capacidad de aprendizaje, con errores que superaron las 60 unidades en algunos casos, a pesar del uso del optimizador ADAM (Zhang, 2018) con una tasa de aprendizaje baja (Brownlee, 2020). RN 2 mostró una mejora considerable, con predicciones más cercanas a los valores reales, aunque aún se observaron errores importantes, especialmente en casos con valores altos de EOQ. El uso de una tasa de aprendizaje mayor (0.01) permitió una mejor adaptación del modelo, pero no fue suficiente para lograr una alta precisión.
Por otro lado, RN 3 fue el de peor desempeño, generando salidas constantes e incorrectas, sin lograr captar relaciones significativas en los datos, lo que lo hace completamente inapropiado para el problema. Finalmente, RN 4 logró acercarse más a los valores reales y presentó el segundo RMSE más bajo, con algunas predicciones bastante acertadas. Sin embargo, aún se observaron diferencias notables en ciertos casos, lo que limitó su fiabilidad total. En general, aunque hubo mejoras en algunos modelos, la precisión y capacidad de generalización fueron determinantes. El modelo seleccionado fue aquel que logró superar estas limitaciones, ofreciendo una solución más robusta y confiable para la predicción del lote económico óptimo en contextos de optimización de inventario.
La Figura 2 indica la dispersión de cada modelo que no fue seleccionado, las gráficas muestran la relación entre los datos reales y las estimaciones de cada modelo. Los valores verdaderos se representan como una línea roja continúa, que sirve como referencia de los resultados reales. Las predicciones del modelo, por otro lado, se muestran como puntos azules dispersos a lo largo del gráfico. Cada punto azul corresponde a una predicción para un valor en específico, y su posición refleja la discrepancia entre la predicción del modelo y el valor real. En general, cuanto más cerca estén los puntos azules de la línea roja, más preciso será el modelo en sus predicciones.
Figura 2.
Gráfico de dispersión de los
modelos no seleccionados
RN1 RN2


RN 3 RN4


Modelo óptimo de Red Neuronal Artificial
Estructura
Como punto de partida se toma en cuenta a tres conjuntos de datos denominados neuronas, que forman la primera capa de la red (capa de entrada). Cada uno de estos grupos de datos corresponde a una variable que alimenta el modelo. La arquitectura general de la red neuronal propuesta es sencilla. Esta estructura permite que el modelo aprenda y optimice la dinámica de toma de decisiones relacionada con la gestión de inventarios, utilizando variables de entrada para calcular la cantidad más adecuada de productos a pedir (Figura 3).
Figura 3.
Estructura del modelo
seleccionado

Para una red neuronal es importante separar los datos en grupos de entrenamiento, esto para garantizar que el modelo sea estable, fuerte y generalice de manera adecuada. En esta investigación, los 3,540 datos destinados para el análisis de la red se dividieron en tres grupos: entrenamiento (80 %), validación (10 %) y prueba (10 %)
Los datos de entrenamiento se usaron para enseñar al modelo, ajustando sus parámetros para minimizar el error. La validación se usó para evaluar el comportamiento del modelo durante el proceso de entrenamiento. Este conjunto permite afinar los hiperparámetros (tasa de aprendizaje, número y tamaño de las capas ocultas) de la red neuronal, y sirve para detectar el sobreajuste. Finalmente, el conjunto de prueba que no ha sido utilizado en ninguna parte del proceso se usó para evaluar el desempeño de adaptación del modelo, es decir, cómo se comportará la red neuronal con datos nuevos. Esta separación asegura que el modelo no solo aprenda a memorizar los datos, sino que también sea capaz de generalizar a situaciones reales.
Creación, entrenamiento y evaluación del modelo óptimo
Se emplearon capas tipo Dense, adecuadas para las redes neuronales de regresión ya que permiten una arquitectura totalmente conectada entre la capa inicial, intermedia y final (Fierro, 2020). Para evaluar el desempeño del modelo, se utilizaron funciones que permiten analizar la discrepancia entre la predicción y el resultado esperado. Es decir, en cada iteración se genera una estimación que se compara con el dato real y para medir esa discrepancia se usó el Error Cuadrático Medio (ECM), que detecta y castiga los errores grandes en la predicción. El objetivo principal es bajar al mínimo este error, para lo cual se implementó el optimizador ADAM que regula la tasa de aprendizaje y es menos susceptible a oscilaciones o a quedar atrapado en mínimos locales.
Se realizaron 50 entrenamientos de la red neuronal, evaluando su desempeño en cada uno. Se utilizaron 250 épocas y dos configuraciones de tamaño de lote: una con 50 y otra con 32. Esta última mostró mejores resultados en precisión y rendimiento, lo que permitió optimizar el aprendizaje del modelo tras la separación de los datos de entrenamiento y validación.
Predicciones del modelo seleccionado
La Figura 4 muestra el desempeño del modelo al contrastar los datos observados con las estimaciones generadas. La línea roja diagonal indica una correspondencia perfecta, es decir, donde el modelo alcanza la mayor capacidad de precisión. La alineación cercana entre la línea y los puntos sugiere que el modelo funciona con precisión y ha aprendido los patrones del conjunto de datos de entrenamiento y está utilizando ese conocimiento para arrojar datos cercanos o iguales a los observados, siendo un indicio positivo de rendimiento y capacidad para hacer predicciones confiables.
Figura 4.
Valores reales vs Predicciones
del modelo

A continuación en la Tabla 6 se presentan algunas de las predicciones realizadas utilizando los datos de entrenamiento el modelo entrenado. Para llevar a cabo estas predicciones, se utilizó como punto de referencia el valor actual de EOQ calculado, lo que permitió evaluar la precisión del modelo. La mayoría de las diferencias entre las predicciones y valores reales son pequeñas, lo que indica que el modelo es bastante preciso, mostrando una alta capacidad para ajustarse a los datos históricos disponibles.
Tabla 6.
Diferencia entre valores
reales y predicciones
|
EOQ Real |
Predicción |
Error |
|
149 |
138.24 |
Error > 5 Dentro del margen aceptado |
|
33 |
24.09 |
|
|
58 |
53.28 |
|
|
33 |
31.45 |
Buena predicción El modelo acierta |
|
70 |
70.08 |
|
|
10 |
9.53 |
|
|
47 |
47.13 |
|
|
81 |
81.07 |
|
|
60 |
61.56 |
Predicción superior Dentro del margen aceptado |
|
49 |
50.95 |
|
|
185 |
187.44 |
Fuente: Los autores
Ahora se muestra un ejemplo del comportamiento del modelo entrenado con datos fuera del entrenamiento para realizar predicciones (Tabla 7). Al recibir nuevos datos de entrada, como el valor de la demanda para el cual se requiere el pronóstico, la red utiliza el conocimiento adquirido durante el proceso de entrenamiento para realizar predicciones precisas sobre los resultados esperados. De esta manera, una vez que el modelo está entrenado, el usuario únicamente debe ingresar el valor de la demanda, y el modelo se encargará de realizar el resto del cálculo y proporcionar el pronóstico correspondiente.
Tabla 7.
Breve ejemplo de predicción
con RN
|
Tela |
Demanda |
Predicción m |
Demanda |
Predicción m |
|
Tipo 1 |
30 |
98.97 |
100 |
145.13 |
|
Tipo 2 |
15 |
33.29 |
50 |
62.27 |
|
Tipo 3 |
40 |
75.9 |
10 |
31.16 |
|
Tipo 4 |
20 |
25.96 |
150 |
192.66 |
|
Tipo |
60 |
72.35 |
37 |
57.18 |
Fuente: Los autores
Finalmente, se presenta un resumen de las características clave de la red neuronal utilizada en el modelo óptimo para la predicción de EOQ (Tabla 8). Con un proceso de entrenamiento que abarca varias épocas y el uso de un optimizador eficiente, el modelo ha logrado alcanzar un equilibrio adecuado entre precisión y rendimiento. La red ha sido diseñada para manejar la complejidad de los datos de entrada y proporcionar salidas que faciliten la toma de decisiones, asegurando así que el modelo sea efectivo y eficiente en su función de pronóstico.
Tabla 8.
Características del modelo óptimo
|
Capa de entrada |
Demanda |
|
Costo por almacenamiento |
|
|
Punto de pedido |
|
|
Capa de salida |
Economic Order Quantity (EOQ) |
|
Arquitectura Neuronal |
Feed-forward |
|
Capas ocultas |
1 |
|
Capas ocultas (Neuronas) |
6 |
|
Función de transferencia |
ReLU |
|
Función de rendimiento |
Error Cuadrático Medio |
|
Número máximo de épocas |
250 |
|
Algoritmo de Optimización |
ADAM |
|
Parámetro de aprendizaje |
0.01 |
Fuente: Los autores
Los hallazgos de este estudio coinciden con investigaciones previas (Pulido et al., 2020) que una gestión ineficaz de inventarios repercute en el control de niveles, causando tanto escasez como exceso de productos. De igual manera se ha evidenciado que un deficiente control en el inventario impacta negativamente en la rentabilidad, además de minimizar el desempeño del aprovisionamiento, al no asegurar un suministro constante de productos en el tiempo y lugar adecuados, aumentando el riesgo de inventarios obsoletos (Orobia et al., 2020).
El modelo de Cantidad Económica de Pedido con demanda estocástica se adapta a las necesidades requeridas por la empresa en términos de incertidumbre y características del producto comercializado. Este enfoque se alinea con estudios previos que señalan la dificultad de prever la demanda en el sector textil debido a la alta incertidumbre en las previsiones (Julcarima, 2018). La implementación del modelo redujo significativamente de los costos de pedido (45 %), costos de almacenamiento (36 %) y costos de mantenimiento (39 %). Además, de un incremento del 4 % en la exactitud del inventario y del 6.5 % en el nivel de rotación de mercancías.
La incorporación de redes neuronales al modelo EOQ probabilístico permitió mejorar aún más la precisión en la toma de decisiones, facilitando el cálculo de la cantidad de pedido sin necesidad de grandes volúmenes de datos. Este enfoque es respaldado por estudios recientes (Cholodowicz & Orlowski, 2022) que reportan aplicaciones exitosas de redes neuronales para predecir la caducidad de productos, logrando una reducción de costos del 20 % con una precisión de entre el 93.8 % y el 98.6 %. Estos avances reflejan el papel de la inteligencia artificial en la optimización de los diferentes eslabones de la cadena de suministro.
CONCLUSIONES
Por medio del análisis de la situación actual del modelo de inventario y abastecimiento se evidenció que la empresa no dispone de un control adecuado en el inventario que considere los cambios en la demanda, así como los costos de aprovisionamiento y faltantes en existencias. Provocando inversiones ineficientes en función del tipo de producto. La aplicación de la propuesta de un mejorado modelo de inventario se optimizó la inversión en un 27%, reduciéndola de 239,879.85 a 174,090 dólares, con una mejora en el valor económico del inventario del 42 %, frente al 33 % previo.
El nuevo modelo probabilístico logró un aumento del 88 % en la rotación de mercancías, al optimizar los costos de compra y almacenamiento, recalcando la incertidumbre de la demanda además de otros aspectos como el punto de pedido y tiempo de reaprovisionamiento. Asimismo, mejoró el proceso de abastecimiento pasando del 32 % al 41 %.
La combinación del modelo de inventario tradicional con algoritmos predictivos mejora el proceso de aprovisionamiento, al calcular la cantidad de producto adecuado en función de la demanda estimada con un margen de error del 1.01 %, eliminando la necesidad de cálculos repetitivos y extensos, y sin requerir grandes cantidades de datos.
REFERENCIAS BIBLIOGRÁFICAS
Bowersox, D., Closs, D., & Cooper, M. (2024). Inventory. In D. Bowersox, D. Closs, & M. Cooper, Supply Chain Logistics Management (pp. 137-164). McGraw-Hill Interamericana.
Brownlee, J. (12 de september de 2020). Understand the Impact of Learning Rate on Neural Network Performance [Comprender el impacto de la tasa de aprendizaje en el rendimiento de la red neuronal]. Obtenido de Machine Learning Mastery: https://machinelearningmastery.com/understand-the-dynamics-of-learning-rate-on-deep-learning-neural-networks/
Chachalo, M., & Valencia, R. (2025). Control de Inventarios para la Mejora en la Gestión Logística. Arandu UTIC, 12(2), 128-158. https://doi.org/10.69639/arandu.v12i2.896
Cholodowicz, E., & Orlowski, P. (2022). Control of perishable inventory system with uncertain perishability process using neural networks and robust multicriteria optimization. [Sistema de control de inventario de perecederos con incertidumbre]. Technical, 70(3), 1-12. https://doi.org/10.24425/bpasts.2022.141182
Cristopher, M. (2011). Demand management and planning. In M. Cristopher, Logistics & Supply Chain Management Fourth Edition (pp. 89-93). Pearson Education Limited.
Fierro, A. (junio de 2020). Predicciones de series temporales con redes neuronales. Obtenido de Repositorio Institucional de la UNLP: http://sedici.unlp.edu.ar/handle/10915/114857
Julcarima, S. (2018). Aplicación del modelo probabilístico para mejorar la gestión de abastecimiento en la empresa Asociación Cultura Brisas del Titicaca Cercado.(Tesis de pregrado) Retrieved from Repositorio Universidad César Vallejo: https://repositorio.ucv.edu.pe/bitstream/handle/20.500.12692/36980/Julcarim a_RSN.pdf?sequence=1&isAllowed=y
Kotecha, N., & Rio, A. d. (2024). Leveraging graph neural networks and multi-agent reinforcement learning for inventory control in supply chains. Computers & Chemical Engineering, 199, 10911. https://doi.org/10.1016/j.compchemeng.2025.109111
Mora, L. (2012). Indicadores de la gestión logística Segunda Edición. Ecoe Ediciones. Obtenido de
https://books.google.com/books?id=ItzDDQAAQBAJ&printsec=frontcover&dq=Los+indicadores+claves+del+desempe%C3%B1o+log%C3%ADstico+Luis+Anibal&hl=es&newbks=1&newbks_redir=1&sa=X&ved=2ahUKEwjw5IDloNGNAxXmQjABHcYfEIoQ6AF6BAgIEAM
Orobia, L., Nakibuuka, J., Bananuka, J., & Akisimire, R. (2020). Inventory management, managerial competence and financial performance of small businesses. Financial Performance of small businesses, 10(3), 379-398. https://doi.org/10.1108JAEE-07-2019-0147
Pulido, A., Pizarro, A., Sánchez, M., & Rosa, L. D. (2020). An optimization approach for inventory costs in probabilistic inventory models: A case study. Ingeniare. Revista chilena de ingeniería, 28(3). https://doi.org/10.4067/S0718-33052020000300383
Render, B., & Heizer, J. (2014). Administración de Inventarios. En B. Render, & J. Heizer, Principios de Administración de Operaciones (págs. 482-498). Pearson Education.
Taha, H. (2024). Modelos de inventario Probabilísticos. En H. Taha, Investigación de Operaciones Undécima Edición (págs. 553-556). Pearon Education.
Walczak, S. (2019). Artificial Neural Networks. En M. Khosrow, Advanced Methodologies and Technologies in Artificial Intelligence, Computer Simulation, and Human-Computer Interaction (págs. 40-53). Engineering Science Reference. https://doi.org/10.4018/978-1-5225-7368-5
Zhang, Z. (2018). Improved Adam Optimizer for Deep Neural Networks [Adam Optimizer mejorado para redes neuronales profundas]. International Symposium on Quality of Service (IWQoS), 1-2. https://doi.org/10.1109/IWQoS.2018.8624183.
©2026 por los autores. Este artículo es de acceso abierto y distribuido según los términos y condiciones de la licencia Creative Commons Atribución-NoComercial-CompartirIgual 4.0 Internacional (CC BY-NC-SA 4.0) (https://creativecommons.org/licenses/by-nc-sa/4.0/)